Respuesta cortaShort answer
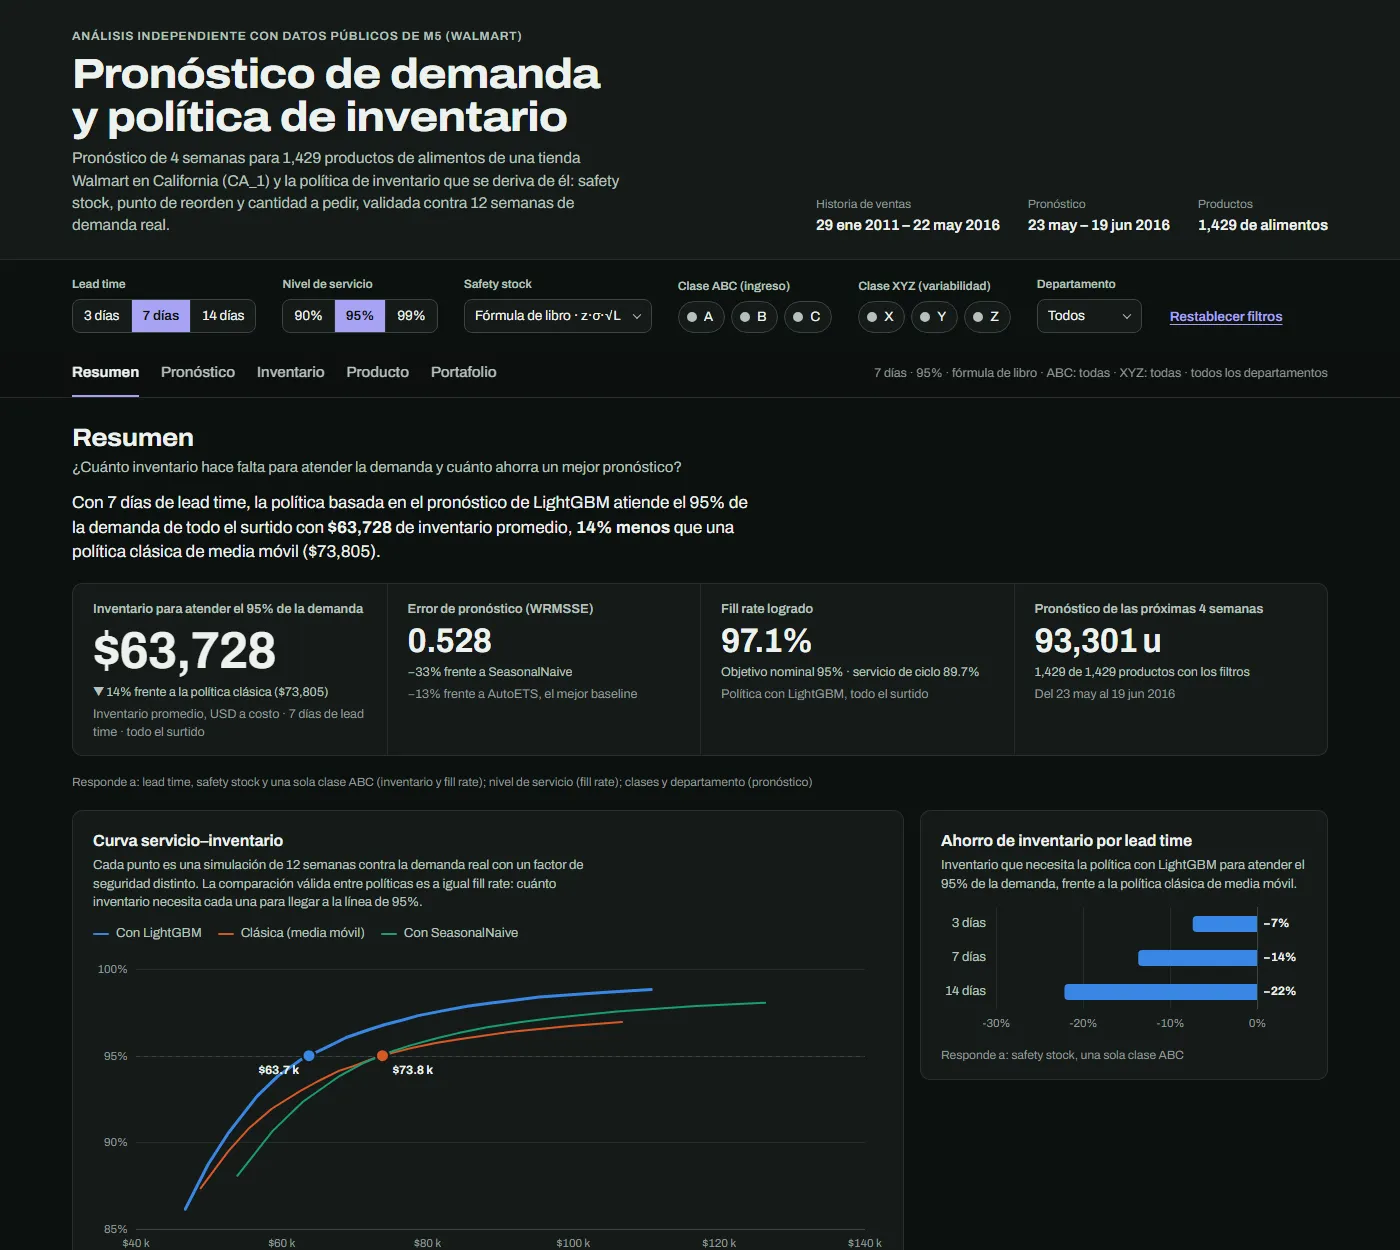
Con un fill rate de 95 % y 7 días de lead time, la política basada en el modelo necesita 14 % menos inventario promedio que una política clásica de media móvil: USD 63.7 mil contra 73.8 mil.
At a 95% fill rate and a 7-day lead time, the model-based policy needs 14% less average inventory than a classic moving-average policy: USD 63.7k versus 73.8k.
| Métrica de éxitoSuccess metric | ResultadoResult | |
|---|---|---|
| El modelo supera a SeasonalNaive en WRMSSE (3 ventanas) | The model beats SeasonalNaive on WRMSSE (3 windows) | 0.528 vs 0.785 (−33 %) |
| Contra el mejor baseline, AutoETS | Against the best baseline, AutoETS | 0.528 vs 0.608 (−13 %) |
| Fill rate en productos clase A (meta ≥ 95 %) | Fill rate on class A products (target ≥ 95%) | 96.8 % |
| Inventario a igual servicio frente a la política clásica | Inventory at equal service versus the classic policy | −14 % · A −11 % · B −25 % |
Reproducible con make all | Reproducible with make all | Sí, CI corre el pipeline completoYes, CI runs the full pipeline |
Lo que encontréWhat I found
- El modelo gana donde hay volumen y pierde en la cola. Mejora el WAPE en los segmentos AX y AY (74 % del ingreso) y empeora hasta 16 % en CZ, donde una media móvil funciona mejor. La recomendación no es usar ML para todo, sino segmentar.
- El ahorro de inventario crece con el lead time: −7 % con 3 días, −14 % con 7 y −22 % con 14. Con un fill rate de 90 % la diferencia baja a 2–4 %.
- El factor
zno entrega lo que promete. Con el factor de seguridad para 95 %, el nivel de servicio de ciclo logrado fue 90 %, y 82 % con la política clásica. Fill rate y servicio de ciclo son métricas distintas y conviene reportar ambas. - Sofisticar el safety stock no lo hizo más eficiente. Calcularlo con σ del error acumulado o con cuantiles empíricos mejoró la calibración, pero el inventario fue el mismo para el mismo servicio. Lo que mueve la curva es el pronóstico.
- Los intervalos de predicción quedan cortos: 74 % de cobertura real para el intervalo de 80 % y 89 % para el de 95 %. No cumple la meta de ±5 puntos que me fijé.
- Una variable "obvia" empeoraba el modelo. Usar
item_idcomo categórica (1,429 niveles) subía el WRMSSE 5.6 % en las ventanas de calibración, así que quedó fuera.
- The model wins where there is volume and loses in the tail. It improves WAPE in the AX and AY segments (74% of revenue) and gets up to 16% worse in CZ, where a moving average does better. The recommendation is not ML for everything but segmentation.
- Inventory savings grow with lead time: −7% at 3 days, −14% at 7 and −22% at 14. At a 90% fill rate the gap shrinks to 2–4%.
- The
zfactor doesn't deliver what it promises. With the safety factor for 95%, the achieved cycle service level was 90%, and 82% for the classic policy. Fill rate and cycle service are different metrics and both should be reported. - A fancier safety stock was not more efficient. Using σ of the cumulative error or empirical error quantiles improved calibration, but needed the same inventory for the same service. What moves the curve is the forecast.
- Prediction intervals come up short: 74% real coverage for the 80% interval and 89% for the 95% one. That misses the ±5-point target I set.
- An "obvious" feature made the model worse. Using
item_idas a categorical (1,429 levels) raised WRMSSE by 5.6% in the calibration windows, so it was dropped.
Cómo lo construíHow I built it
- DatosVentas, precios y calendario de M5 en formato largo, en DuckDB.
- DataM5 sales, prices and calendar in long format, in DuckDB.
- SegmentaciónClases ABC/XYZ y patrón de demanda por producto.
- SegmentationABC/XYZ classes and demand pattern per product.
- BaselinesNaive, SeasonalNaive, media móvil, AutoETS y AutoARIMA.
- BaselinesNaive, SeasonalNaive, moving average, AutoETS and AutoARIMA.
- ModeloLightGBM global con objetivo Tweedie, rezagos, medias móviles, eventos y precio relativo.
- ModelGlobal LightGBM with a Tweedie objective, lags, rolling means, events and relative price.
- Política(s, S) con revisión diaria: safety stock, punto de reorden y lote EOQ.
- Policy(s, S) with daily review: safety stock, reorder point and EOQ lot size.
- SimulaciónCada política, día a día, contra la demanda real.
- SimulationEach policy, day by day, against real demand.
De las seis ventanas de 28 días, las tres primeras sirvieron para calibrar: ahí elegí las variables y estimé la incertidumbre del pronóstico. Solo reporto las tres últimas, para no tomar ninguna decisión mirando el periodo evaluado.
Of the six 28-day windows, the first three were used for calibration: that's where I chose the features and estimated forecast uncertainty. I only report the last three, so no decision was made by looking at the evaluated period.
Lo que no se puede afirmarWhat this can't claim
- Los datos son de una tienda de Walmart en California, no de un retailer mexicano. El método se transfiere, pero las cifras no.
- Los intervalos de predicción tienen menos cobertura de la nominal, así que el safety stock basado en ellos queda corto en algunos productos.
- En los productos de baja rotación (CZ) el modelo es peor que una media móvil.
- Las reglas de M5 no permiten redistribuir los datos: el dashboard publica solo resultados derivados, y el código falla si aparece una venta diaria o un precio.
- The data comes from one Walmart store in California, not a Mexican retailer. The method transfers; the numbers don't.
- Prediction intervals under-cover their nominal level, so safety stock based on them falls short for some products.
- For slow movers (CZ) the model is worse than a moving average.
- M5 rules forbid redistributing the data: the dashboard publishes only derived results, and the code fails if a daily sale or price ever shows up.